Agent 时代的自我技术俏也 · 分享会
自我技术 · Agent 时代

Agent 时代的 自我技术

从书写、内观到创作——用 AI 搭建属于自己的系统,附现场问答实录

当 AI 可以完成知识学习、技能获取、工具性产出甚至创作的时候,「知道我是谁」和「我想要什么」变得前所未有的重要。

进入正文作者:俏也
Act 1

引入 — 「生活技术」与「自我技术」

什么是自我技术?为什么在这个时代,知道自己是谁、想要什么,变得比任何技能都重要?

01

俏也的生活技术

我不太擅长做自我介绍,但总之,我被很多人知道是因为我经常会做一些关于我的「生活技术」的分享。所谓生活技术,可能就是关于你怎么不消费,怎么不参加工作-消费的循环,怎么能够应对现在的系统,去构造自己的一套生态体系,持续地好好活着。

这个是我一直在践行、在分享的东西。对我来说,它关乎去构建更多具身的第一人称经验。在各个方面,我可能都会去想——这个东西适合我还是不适合我?虽然大家都说好,但对我来说可能是不好的。我就得自己去试、去感受、去调整。

举几个具体的例子:我现在有三年没有花过住宿费,一直在世界各地到处乱跑。我从来没有正式上过班,一直在做我自己想做的事情——这件事我不想做,我就不会做。我大概觉得我有一个可持续的系统,我把它叫做一种生活技术,我觉得它是我们在这个时代,在尝试构建自己生态体系的过程中很核心的东西。

02

规训技术 vs 自我技术

福柯讲了很多规训技术——这个社会是怎么内化各种价值观、各种标准到我们内心的。学校教我们专业知识,纯为了就业,为了让你能够走上就业市场。上了就业市场之后,你继续运用在学校里学到的那一套:要准时、要勤奋、要努力、要遵守规则、有绩效。反正就是一个整体的循环。

福柯在晚年的时候去想了一个问题:除了社会怎么控制我们之外,我们自己是怎么控制自己的。他提出了一个词叫自我技术——「允许个体通过自己的方式,对自己的身体和灵魂、思想行为和存在方式进行操作,从而改变自己。」

他提到古希腊人以前都会有个本子,把日常的思想、做过的事反思并记下来。我觉得这是一个起始的线索——为什么我在做这些事情。或者说我自然而然发现,我好像对书写特别感兴趣。后面会发现我写了很多东西,跟书写听起来也不谋而合。这个也是我们今天的一个线索,因为基本上后面都是关于文档、文字的处理。

03

自我技术的形式

福柯晚年转向研究「自我技术」(technologies of the self)。他区分了四种塑造主体的技术——生产技术(操控物体)、符号系统技术(运用符号和意义)、权力技术(支配个体行为)、自我技术(个体对自身的操作)。自我技术是他晚年最核心的关切:个体通过自己的力量或他人的帮助,对自身的身体和灵魂、思想、行为、存在方式进行操作,以此达成自我转变,以求获得幸福、智慧、自由。

他分析了古希腊到早期基督教中自我技术的几种具体形式——

  • 给朋友的信与自我揭示(斯多葛派):不是汇报,是通过写给另一个人,让自己更清晰地看见自己
  • 对良知的审察:一天结束时,回顾做了什么事、应当做什么事,比较二者。审判是要判你这个人怎么样,核对只是看看差距在哪里
  • 聆听的艺术:普鲁塔克说,我们在学校里学习如何倾听逻各斯的言说,此后整个成人生活都必须这样做——分辨何为真实、何为谎言
  • parrhesia(直言/说真话):不是对别人说真话,是对自己——「照看自己」的前提是,你敢不敢对自己说真话
04

规训 vs 自我:你现在的日常活在哪个逻辑里?

规训技术自我技术
谁在操作外部权力(学校、公司、平台、算法)你自己
目标把你变成「可被管理的合格的人」把你变成「你自己想成为的人」
方向客体化——你是被观察、被定义、被修正的对象主体化——你是观察者、定义者、修正者
工具考试、绩效、排名、算法推荐、全景监控书写、回看、对话、如实记录、自我审察
结果驯顺而有用的身体自我转化——幸福、智慧、自由
典型话语「你应该」「正常人都」「别人都」「我发现」「我选择」「我试试」
05

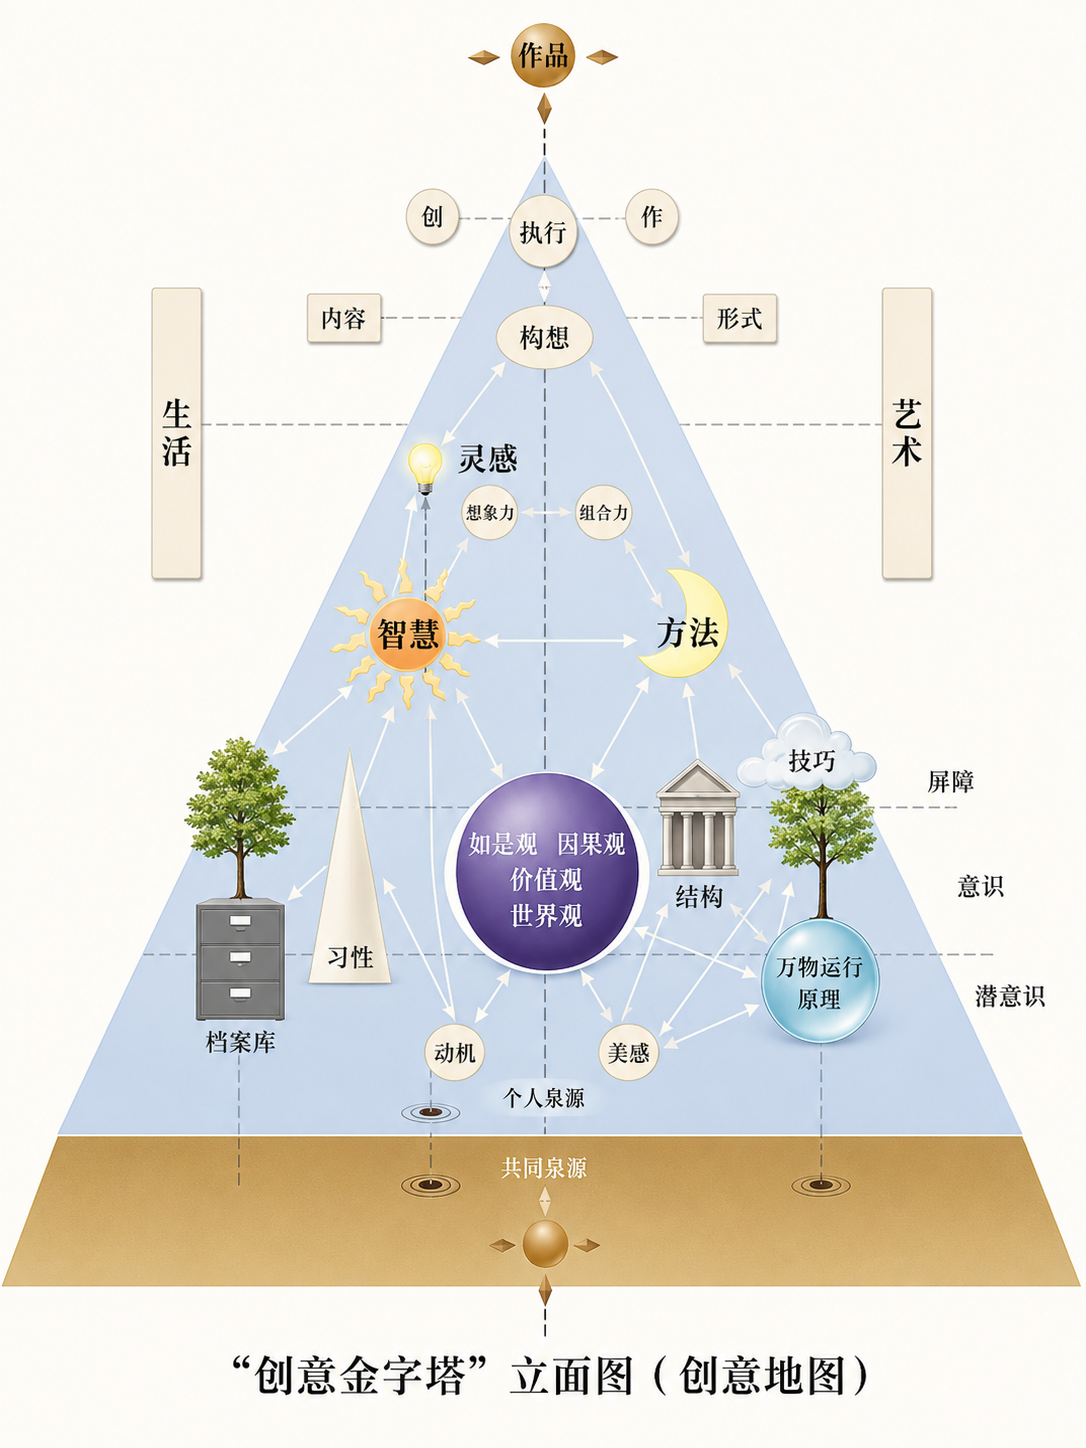
创作的本质 — 赖声川创作金字塔

还有一个我想先引入的概念是创作。这个是赖声川提出的创作金字塔。他把创作分为生活和艺术两块,底层的共同源泉是人类的潜意识。

首先是档案库——你经历了什么。他提到自己去哪里旅游,突然看到一个古堡,在古堡中想到一个故事,就在路途中收集了很多碎片,有了一个剧本的构想。大概就是我们平时在积累的:生活中发生的点点滴滴,一些灵感。

然后它会经过我们的习性——首先是一个数据库,有一个内在的档案库,然后你会有个操作系统去把这些档案连起来。核心的几个观念:你的价值观、世界观——你是怎么组织这些东西的。他提出你可以更多地看因果联系,不要只看到一个事物本身,看到它和哪些东西连起来。还有如是观——你能原原本本地看那个东西,而不是以标签去评估它。

有了灵感之后,加上方法,加上不同媒介的技巧——内容加上形式,就产生创作。对我来说也很有启发性,我觉得它也能串起来我今天讲的各个部分。

赖声川创作金字塔


06

系统八层金字塔 — 赖声川映射到我的系统

我在做的是:原始数据库——我搜集了特别多我的数据,然后我在想,我可以做点什么。我去整理了我的世界观和价值观——我到底对于世界的认知是什么,我的知识图谱是什么样的。然后去观察我这么久以来,我有什么反复出现的模式,我有什么根深蒂固的想法,我的动机是什么,我为什么会这样做,为什么会成为这样的人。

这些就类似于赖声川讲的那些——怎么去获得智慧的途径、形式和媒介。所以今天我会讲我在做的几个事情:书写、怎么组织、怎么搭建知识库。我们有了很多数据之后,它就能从更长的时间维度、更多不同的角度去看——在我而言发生了什么。有了足够的素材之后,就是我现在输出的工作流。我还顺便做了一个数字分身——因为刚好有了知识库、有了记忆、有语料库、有我怎么写作、有我怎么想的。

赖声川创作金字塔 vs 俏也系统
Act 2

今天涵盖的各个模块

从书写到内观,从创作到分身——互相支撑的实践方向,以及贯穿它们的数据流。

07

输入 → 组织 → 觉察 → 创造

我现在做的大概是这些事情,大家可以在 ciaoye.github.io 看到入口——

  1. 书写与知识库搭建:怎么书写,把碎片变成资产,搭建成知识库。对应赖声川的「数据库」——内在储存的一切档案库。flomo 的零散记录,加上各种平台的数据,最终变成一个双链知识网络。
  2. 数字内观:通过和 AI 对话完成「毗婆舍那」(Vipassana)——佛教的认知自我、抵达自由的技术。用不同切面反思经历过的事情。我们现在都会去和 AI 聊「我发生了什么」「我遇到了什么问题」,我在这个部分会提供更多方法论。
  3. 创作:有了足够素材和对自己认知后,怎么和 AI 做创作。智慧结合形式之后的创作。我自己写——语音转文字,交给 AI 整理。但重要的不是去 AI 味儿,是找到你的味道。
  4. 数字分身:基于知识库、记忆、自我认知和语料库,做一个「我的 AI」。由人格层、知识检索层、记忆层三部分组成。你可以决定它完整的 prompt,它能读到哪些信息——这也让我更了解这个生命形态。
08

文件夹架构全景

我所有东西都在本地的工作目录,以 Markdown 的形式。下面这张图是系统落地的真实目录树。

trae_projects 全工作区目录结构
09

完整的数据流

从原始数据源出发,数据的采集,然后进行了一些数据的预处理。预处理之后,它有两个主要的流向:

  • Wikipedia:主要是知识性质的——知识、观点、概念。比如说 2025 年、2026 年的内容。不是情绪类的。
  • 不同年龄的我:更长时间段的,编年史形式的。

这些东西都会进入一个觉察层——做更多的报告,进行自我认知和反思。其他一些输出——大家对外能看到的是我的写作、我的 blog、我的 OS,我的分享会也算。

完整的数据流
10

同样的方法,适用于其他领域

我讲的方法,它其实适用于很多领域。因为刚好我非常了解我的个人数据,我的研究对象是我。如果你是组织,你可以把你们关于组织的文档收集起来。你在运营一个公众号,这公众号可能不是你个人的,你可以把所有的公众号文章拿下来。不管你在哪个地方,方法论很多是适用的:

  • 搜集原材料
  • 把原材料组织成一个体系
  • 觉察里面可能反复在发生什么事、有什么核心的矛盾
  • 根据觉察去做更多的创造

这些都是一样的技术。

Act 3

Agent 时代的变化

AI 改变了知识输入的方式,也改变了从想法到现实的路径。但有些东西不该交给它。

11

人脑 vs AI:各司其职

我现在用的是 Agent。Agent 区别于 chatbot。以前我们都是在网页上聊天——你给 ChatGPT 发一个文件,他说好,我帮你整理一下,然后把文件发回给你。Agent 的时代让我们可以在电脑上——它能读取你本地的文件,有本地文件的权限。一个想法到出来会很快。

我觉得我发现适合我的地方。因为我之前作为一个碳基生物,我非常不喜欢整理我的笔记。比如说我 flomo 里有几千条笔记,但是我都没有打标签。然后我是觉得,我光靠自己也能输入和输出——因为我的大脑也有很多的神经元,我有长短期记忆,我晚上还会做梦去处理我白天遇到的信息。我不喜欢写小红书——我有很多年一写小红书就会很烦。我特别不喜欢公众号排版,我也不喜欢总结。我觉得这些结构它都是让我不舒服的。我是一个说话说到哪儿算哪儿的、非线性运作的人。

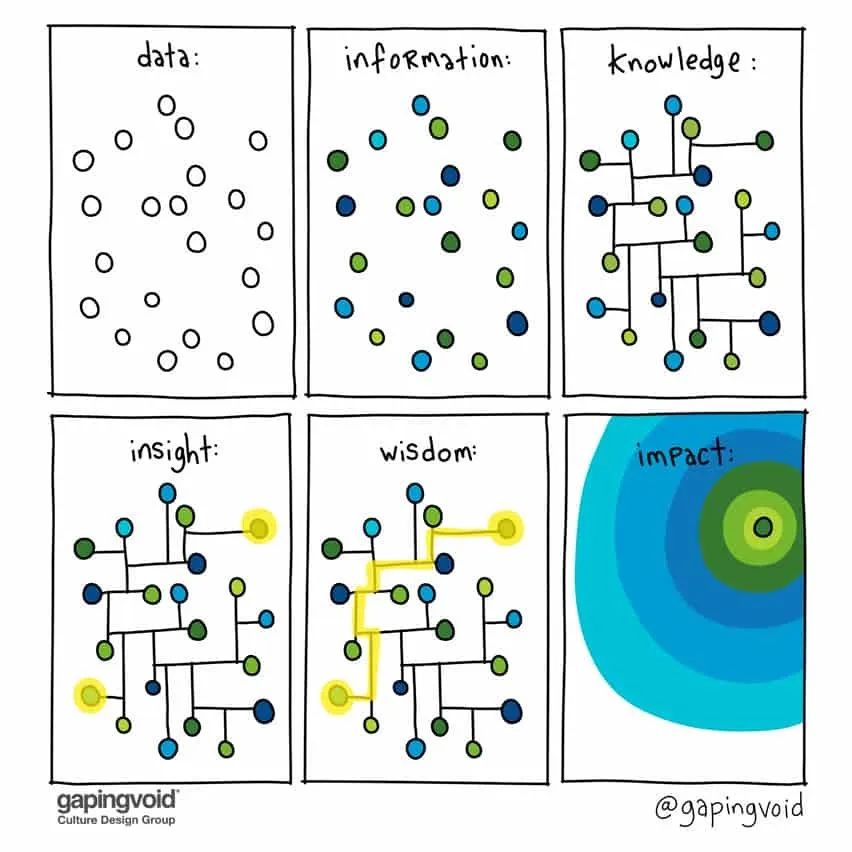
我以前也读过卡片笔记,我很喜欢——本身你的记录可能就是碎片的,它们如果在中间有相关性的连线,它们就能够变成知识。也许我们都感觉到,当你听到一个观点的时候,你有一种恍然大悟的感觉,那个时候点可能就在你的神经元、在你的某些概念连成了一条线,你就觉得——这个是 insight。有了更多的 insight 就可能会产生 wisdom。至于那些忘了的、想不起来的——那说明它对我来说不重要。像我看书,我也不喜欢做什么读书笔记,我觉得我记住的东西它就能连上,我没记住的就算了。

然后当 Agent 出现之后,我发现——它好像是能够去做工作的。它能够去控制我的电脑、读写我的文件,然后去维护说:「和你好像是相关的,你五年前记过这一条笔记,你想不想看一下?」所以——我喜欢熵增的状态,有了 Agent 之后它就能达到一个熵减。它可以帮我去整理。

这样的话,人可以做人应该干的事情——你有你的 taste,你有你长期经历的直觉,你能够去表达「我想要什么」。AI 可以去帮你去执行和完成。我觉得是这个时候,非常合适做我现在做的事情。
没有 Agent 之前(人类) Agent 时代 大数据库 神经网络 模糊感知 非线性 厌恶结构化整理 熵增状态 顿悟时刻 神经元自发连接 低摩擦记录 结构化整理 维护双链 200+ 页 / 7000+ 双链 控制电脑、读写文件 写代码 有机 · 自然状态 机械 · 扩展状态
[SVG: organic-vs-mechanical.svg]
卡片笔记:散点连成线

图片源自 Gapingvoid.com — 散点连成线,线变成线索和洞察

12

通用智能 × 定制体系

有了通用大模型之后,可以在此之上定制化自己的体系——

  • 把赖声川的体系喂进去 → Agent 给你详细的清单和方案
  • 把斯坦福人生设计课喂进去 → 以前它是个工作坊你要去做练习,现在可以扔给 AI,你还可以告诉它「我好像更喜欢这个、不喜欢那个」
  • 把教练技术喂进去 → 让它变成你喜欢的教练。你可以挑你喜欢的流派,不同的流派观点和方法都不一样,把书直接喂给 Agent,让它按照这个方式跟你对话
  • 健身运动也是——我是女性,现在市面上很多是针对男性的,我是一个多少年纪的女性,我在哪些部位是有一些代偿——总之有了通用大模型,我们可以给它框定不同的体系

知识输入方式根本性地变了——不再是单纯阅读,而是互动。我觉得也是我很喜欢的一点——你可以去定制和做最适合你的部分。

13

举例:输入赖声川的书

我举了个例子——不是我做的。我只是很简单的把赖声川金字塔的那本书扔给 Agent,说「你作为 agent,我们是可以怎么完成这个创作过程的?」这就是他的回答——他把创作体系映射成了六类 Agent,从积累素材到管理创作状态,形成一套完整的创作辅助系统。

赖声川创作体系 六类 Agent 映射 核心任务 经验档案库 积累 Agent 把碎片整理成可检索的 创作素材 如何看 / 去标签 / 三观 视角 Agent 换个角度看已看惯的 东西 连结的秘密 连结 Agent 强行做"意外关联" 创造新的连结 方法的机器 / 结构 结构 Agent 灵感和素材变成可执 行的创作结构 测谎器 / 如是观 测谎 Agent 找出作品中不真诚的 地方 个人仪式 / 闭关 执行 Agent 管理创作状态和心流
[SVG: six-agents.svg]

你只要把任何的书、任何的文章扔给他,你觉得这个文章对我有启发——「我们能不能探讨一下,你能不能用这上面写的方式来问我?」他就可以跟你完成这个过程。我觉得也是我很喜欢的一点。

14

想法 → 现实,前所未有的快

想法到现实是非常快的。以前比如说想做游戏,你可能得先挑——我是在 Unity 平台好,还是用哪个引擎比较好,我要先怎么上手。现在可能成本就非常低。

我觉得是很多人——像我这样的很多人——总是想要多于做。先想很多:到底是选 A 选 B 还是选 C,经常在这个地方卡住。有了 AI 之后,它可以很简单——我们 ABC 都试一下,然后你就知道,好像这里不行,B 这里好像是可以的。你能拼出一个方式。

所以想法到现实,它像神笔马良一样——你只要跟他说「好,现在帮我写一个贪吃蛇的游戏」,他就能直接给你做。成本变得非常低,可以快速迭代。

15

什么不该交给 AI

让 AI 做重复性、工具性工作,人保留直觉、审美、玩耍、创造。这个是明确的分工。但过程中会出现边界模糊,我就会非常不舒服——

让渡自己的思考。你说:「我今天要做一个 Agent 的分享,你帮我写十篇文章。」AI 去网上搜了一些资料,写了十篇。你去发布它——你相当于在为 Agent 工作。这些东西可能没有经过你的检查,跟你没有关系。

人把自己工具化。历史上所有的技术发明出来之后,提升生产力,反而我们又得到了更长的工作时间、更重的 KPI。早在工业革命的时候大家就预测未来的工作时间会越来越少——其实并不是。人现在就变成了一个使用 AI 的部件,为了更高的效率去使用 AI,就变成了一个操作 AI 的东西。

我觉得很多时候要回到自己到底想做什么和想要什么。这些工作都被 AI 做了——那我还剩下什么?他写的文章比我好很多倍——那我为什么还要写东西?我觉得在未来很长的一段时间,这都是人类会一直去思考的。

16

Skin in the Game

Nassim Nicholas Taleb(写《反脆弱》《黑天鹅》的人)讲过一个概念——非对称参与者。一个人提出建议和观点,他不承担后果,那他的观点是没有可信度的。他跟这件事毫无关系,他没有把他的钱投在上面,没有把他的利益相关投在上面。

典型例子:网上教你怎么投资的人——他没有自己投,他告诉你的观点不会损伤他的利益。咨询顾问到公司来给你把架构整一下——整完了,公司好还是坏跟他没关系,他已经拿到咨询费走了。

AI 就是非常典型的非对称参与者。它没有任何时间线——没有昨天,没有今天。你问它,它就告诉你,按照它的概率分布——它能给你一万种建议,但它没有办法为任何一句话负责。假设未来 AI 算力更厉害,它告诉你说「这个是最优解」,你可能很难去评估那一万种,你就说「那按你的做」——这个时候你是承担风险的那一方。

所以不管我们讨论 AI 有没有意识,我觉得重要的是——AI 就是一个非对称的参与者。到底你跟它的相处界限是什么样?你要去承担责任。

17

「知道我是谁」变得前所未有的关键

知识容易获得了——提问就能获得。那提出问题就变得更重要。知道你想要什么变得更重要。

实现你想要的很简单——一句话就能驱动很多算力。但如果你不清晰,你的不清晰就会被放大。

当知识的学习、技能的获取、工具性产出甚至创作都能被 AI 完成时——「知道我是谁」、「我想要什么」变得越发重要和必要。AI 能给你一万种方案——你怎么选出那个「属于你的」?

我觉得这也是和「自我技术」非常相关的。这就是为什么我想专注于聊自我技术。

Act 4

搜集个人数据

你的数据比你想象的丰富。关键是——记下真实的自己,而不是「应该的自己」。

18

盘点数据资产

我会讲一下我搜集了哪些数据——

平台内容时间跨度
flomo我从 2022 年夏天开始记的,是我平时记得最多的,非常喜欢的笔记工具。大概两千多条,随手记的想法,一句话两句话也都在里面2022-2026
微信聊天记录我说了我是一个不喜欢整理的人,我有几千个联系人,都没有标签,都得靠上下文去回忆这个人是谁。但我很认真地保留了我的微信聊天记录。我有个小学就认识的朋友,快二十年了,我有他十年的聊天记录。挑了各个阶段的聊天比较多的人2016-2026
与 AI 的聊天记录DeepSeek 我用一个插件 down 下来的,Gemini 的 Google 直接可以下载。ChatGPT 我没有很私人的对话2023-2026
QQ空间我导出了日志和说说,比较早的 2008 年。但我小时候删掉了很多说说——因为觉得很羞耻,初中的时候看到小学发的东西觉得实在是太幼稚了,要不然还能有更多2008-2016
朋友圈早期比较少,和 flomo 高度重合2013-2026
长文章飞书、公众号、豆瓣帖子,这些都是我手动下的2023-2026
Google Activity2016 年至今全部网站的访问量——我到底访问了哪些网站、搜了什么东西、翻译了什么。下载下来就行,一点都不花功夫2016 至今

如果你没有这么多数据也没关系。一开始我只有 flomo,后面的都是我觉得「好有意思,我再多找一点」。你可以先挑你觉得最核心的、跟你现在最贴近的来做。你现在可以开始记录——挑你最感兴趣的话题。你也可以找 Agent 去找一些话题来聊——跟它说「我现在想做这样一个项目,你来问我,我语音转文字给你讲」。你有一些就做一点。

19

processed 架构:标准化记录的落地

3,912 个原始文件 → 经过全量标准化脚本处理后,落到 processed/ 目录:

  • records/:12,999 条标准记录 + 337 条附件记录,JSONL 格式(records_2008_2015.jsonl 等),每条记录含:id、来源文件、时间戳、内容摘要、类别标签、情绪标记
  • yearly/:62 个「类别×年份」分区,每个分区包含对应类别和年份的所有标准记录
  • attachments/:关联的附件文件(图片等)
20

记下你不敢承认的,才是真相

对于记录来说,我觉得比较重要的一件事:在 AI 的时代,它已经输入了大量的公共文本——非常平均化的知识、陈词滥调、概率最大的东西。如果是做自己的记录,最好是记自己主观的、亲身的经历的数据。

我之前参加暂停实验室关于睡眠的练习——他们说你不要用手表去记你的睡眠,不要用任何智能的。自己去想「我昨天好像是什么时候睡的」,自己去写。用主观的数据去替代客观的数据——让主观成为你的客观。

像我现在学中医,他说你要跑步,你要去感受你跑步——你不要看手表上的数据,你不要看 app 告诉你怎么跑。你要自己主观地去评估:你跑的怎么样?你跑的舒服吗?发生了什么事情?这些就是第一人称的科学——用觉知作为观察仪器。

我觉得很有印象的:我把我的简历放给了 AI。简历就污染了很多数据源——因为它是美化过的,写了什么我几年在这公司干了多少事情。然后它就出现在了很多地方——出现在了我个人经历的列表里面、我做过什么事的里面。非常的尴尬。

所以你可以更真实地去记。那些你跟别人不会说的想法、那些很私密的东西、那些你觉得很羞耻的东西——它非常值得被记下来。在 AI 时代,这份真相是你最难被替代的特异性。

21

上下文 > 分类与数据预处理

关键是说清楚「这段为什么在这里」。我在看我的数据的时候发现有很多东西没头没尾——因为我以前没有那种很详细的写作习惯。比如说 2008 年我的大部分记录都是:「好烦」、「好想死」、「今天好开心」、「作业好多怎么办」。只有一个很简单的情绪词,我完全不知道发生了什么。所以后面很多都是胡猜的。

还有一些东西是别人的引用——我复制粘贴了别人的话,没有用我的话经过转述,也没有标注来源。AI 就觉得是我说的,就会污染我的数据处理。

我之前想的是要给所有东西打标签——后来发现打标签这个东西没有什么用。因为你能看懂 AI 就能看懂,你不需要再增加标签了。但是上下文是很重要的——这一段东西你是为什么写的?如果有印象可以去补,没有印象就流失掉了。

所以我需要跟 Agent 说清楚:如果数据不清晰,不要乱猜,不要编造我经历了什么。不确定时间的数据请跟我确认。标注好来源——是别人说的还是我说的。

关于怎么记:我是想记就记的——它不是个任务。对于不同人来说,低摩擦可能不一样,得自己去找。比如说语音转文字、微信里发消息,对我来说就很顺嘴。所有的方法都得靠自己去找——适用于你的不一定适用于别人。但所有的结构化工作都可以让 Agent 来做。

Act 5

搭建知识库 — LLM Wiki

把碎片变成网络——LLM Wiki 是活的、会复合增长的「第二大脑」。

22

Karpathy 的 LLM Wiki

Andrej Karpathy(OpenAI 联合创始人)提出了 LLM Wiki 的方法论。核心理念:它区别于以前所有的笔记——Notebook、收藏夹之类的地方——它是持续在维护的。

一篇东西被收录进来,它就会形成很多个页面。如果你只有一篇文章,把文章扔进去,文章可能就会长出五个页面——文章里提到的五个概念或者五个部分。所以它不是存了之后你去找——它每一篇在进入知识库的时候就已经过编译了。进入的时候就已经跟所有其他已经存在的页面发生了联系。

你可以去检索。比如说我现在就能看到我从小到大,在我妈妈的议题上,我跟我妈的关系是什么样。关于归属感,我从小有记录的部分大概是什么样。你可以从图谱里发问,可以去你感兴趣的领域进行询问。知识会慢慢增长——你会发现,原来在这个概念上我可能曾经有过互相矛盾的发言。原来这个问题我 2022 年聊过,后面又聊了一次,有哪些区别。

如果你想做,你只要去搜 Karpathy 的名字和 LLM Wiki,你会搜到他写的一篇文章。把文章直接扔给 Agent,说「我要做这个」,Agent 就会把所有的文件夹给你搭好,所有的体系打好。

从一本本书到知识图谱:用问题定向拓宽边界

参考:shing,AI mindset · Poolside

23

三层架构 + 三个操作

它的架构大概是这样——

三层架构:

  1. 原始资料库:只读封存。你直接扔进去就 ok。
  2. Wikipedia:我用的是老的 Wikipedia 的 UI,它真的就是个 Wikipedia。里面所有的页面都是平等的——没有说一个类目叫做「家人」,家人下面再有一个「我家人都有谁」。放弃图书馆式的分类。所有东西平级,不需要去想这个概念好像更大、涵盖另外一个概念——不重要。现在的语义检索、AI 去建立页面的双链都可以 cover。
  3. 配置文档:讲清楚工作流的 CLAUDE.md。让 AI 按规则来维护。

三个操作:

  1. Ingest(收录):把文档收录进来。比如说这篇文章提到了 A、B、C 三个概念,他会看以前我们聊过 B,就把两个页面连起来说相关。如果 A 之前没提到,就新建一个 A 页面。一篇东西可能长出五到十个页面。
  2. Query(查询):对 Wikipedia 提问。你也可以归档——你觉得这个答案满意,可以把它回写进去,作为新的资料输入。
  3. Lint(检查):定期健康检查——有没有链接连不上的?有没有之前搞错了的?
24

编译型知识 vs 检索型知识

编译型知识的五大优势:

  1. 进入时就完成综合——不是临时检索拼凑,新资料进来就编译整合
  2. 维护成本趋零——LLM 不厌倦,一次操作同时更新十几个页面
  3. 知识会复合增长——每个新信息源丰富已有页面,发现矛盾、补充论据
  4. 人做最有价值的事——筛选来源、引导分析、提出好问题;LLM 做苦力
  5. 探索成果不会消失在聊天记录里——好的回答作为新页面归档回 wiki
知识管理范式:从存、结构、找到持续维护

参考:shing,AI mindset · Poolside

25

Obsidian + Agent:IDE + 程序员 + 代码库

我基本上用的是 Obsidian 加 Agent。Obsidian 是 Markdown 的浏览器——现在对于 AI 来说,比较原生的文档就是 Markdown。它是一种标记语言,就跟 HTML 一样,是个文本标记语言,可以标注出东西的结构——它就是一个更高级的 txt。

所以基本上所有的文档最后会以 Obsidian 的方式存。你会加一个 Agent——因为 Agent 现在可以读你电脑的文档。很简单:你有一个文件夹,你让 Obsidian 读文件夹,变成一个 Obsidian 库,你就能看文件夹。然后你再用一个 Agent 去操作文件夹。

如果是 PDF、PPT——无所谓,你让它转成 Markdown。这些 Agent 都可以帮你批量解决。你跟它说「我要 Markdown」,它就会给你整成 Markdown。这些东西都很简单,你直接跟 Agent 说,它就会帮你干完所有的事情。你要怎么转 Markdown,全是找 Agent——一个网页、聊天记录、PDF,甚至图也可以让有多模态的模型帮你去处理成文本。处理成 Markdown,应该都是 ok 的。

26

收录工作流:flomo → inbox → wiki

这是我实际收录的工作流——

  • flomo:我平时都记在 flomo 上,比较轻量。它会自动拉取我最近发的 flomo,看有没有被收录的,弄下来。
  • 微信/AI 聊天记录:导出来随便什么格式。
  • 腾讯会议分享:比如说今天的分享,我也会语音转文字,再做成一篇文章,还会继续放到 Wikipedia 里。
  • 网页长文章:直接收录。

整体架构很简单——inbox 是待处理的,wiki 是已收录的。我跟他说「你去处理一下 inbox 里面的东西」,他就会去做一连串的更新来维护 Wikipedia。收录的时候我要求——长文章可能会更新十到十五个 Wikipedia 页面。语音稿一篇一篇来。查询我现在做得不是很多,但我写作的时候有很多查询。检查是定期会做一下——有哪些链接是连不上的,有哪些之前搞错了的。

反馈我用的是 Markdown 通用的注释文字:「这里要改一下」、「这里不太对」、「这里好像出问题了」。他在检查的时候会去处理我给他的 feedback。

LLM Wiki 知识管线
📊

LLM Wiki 知识图谱 — 交互式展示

以下是我的 LLM Wiki 知识星云,展示 246 页、7,215 处双链形成的概念网络:

27

Wiki 覆盖的领域

我的 Wikipedia 呈现为一个「概念知识库」——因为最近几年的笔记更多是观点、洞察和想法,不再只是日常记录。我最开始做是因为我准备写书——我之前一直是不喜欢整理的,那我得找个人帮我整理一下,看看我可以写哪些章节。基本上我就让他做了这个东西,就会发现哪些话题我一直在聊,核心话题大概是什么。

它大概涵盖了这些领域:

主题核心问题wiki 覆盖
自我我是谁?我想做什么?我怎么做事?身体 · 情绪 · 自我认知 · 抑郁与生命力 · ADHD · 拖延与行动力 · 恐惧 · 勇敢 · 三分钟热度 · 叙事自我与体验自我
关系爱是什么?怎么沟通?关系 · 亲密关系 · 婚姻 · T-Group · Circling · 家庭 · 沟通与对话
社会怎么在社会生活?为什么焦虑?社会规训 · 教育 · 金钱 · 赚钱 · 优绩主义 · 不配得感 · 爹味 · 社区 · 合作社 · 存在就是家 · 女性 · identity
世界人类正在走向哪里?不消费与生活方式 · 内观 · 灵性与正念 · 显化 · AI · 生态 · 集体潜意识 · 自然 · 万物

之后可能想写书,或建立更有框架性的体系——这个知识库是帮助我完成这个部分的。

Act 6

数字内观 

用数据和 AI 对话,从不同切面认识自己。

28

习性、标签与自动驾驶

什么阻碍了我们获得智慧?赖声川讲了几个——内心的习性、过去的经验、标签化。「他不就是那个啥吗」、「这个是丑的,这个是那个」。就这些东西,让人一直开着自动驾驶。

我引用了内观的概念——内观是佛教里面,通过看自己的念头,感受到「我为什么会升起这个感觉」、「我为什么会升起这个情绪」,去辨析我的习气——我为什么喜欢这个、不喜欢那个。这是从自动驾驶变成手动驾驶。

29

用数据做内观

毗婆舍那(Vipassana)——佛教认知自我、抵达自由的技术。

我搜集了这么多东西,那我也做了一系列的实验去研究一下——我可以通过什么角度去观察,看到不一样的东西。AI 能够让你对自己的人生建模。

因为你可以非常简单地收集——像我刚才把微信聊天记录导出来,让他去看:「这是我和朋友聊的聊天记录,你看一下这里面发生了什么事情。」不用你专门坐在电脑前说「我今天要研究一下这个方向」。它能够去识别模式,能够去看到关联性,然后它能够及时来问你:「这个地方好像不太清楚,你能给我解释一下吗?」

它能让你以一个非常低的摩擦去记录。在一大堆乱七八糟的东西里面,你可以给它很多噪音——它能去找到里面发生了什么事情。

AI 让你第一次能对自己的人生建模

参考:shing,AI mindset · Poolside

30

第一层:采集成本坍缩

对我来说,语音转文字、在微信里发消息——这些都是比较低摩擦的。我的 flomo 连上了微信,我跟他说「我今天打了个车花了多少钱」、「我今天心情不好」,他就会帮我记在笔记里面。我不用专门去用一个 app 去记账,直接在微信里面说就行。

所有这些都可以在一个聊天里完成。它可以变成一个很顺嘴的事情——低摩擦的方式。对于不同人来说,低摩擦可能不一样,得自己去找。所有的方法我觉得都得靠自己去找——因为适用于你的不一定适用于别人。

第一层:采集成本坍缩

参考:shing,AI mindset · Poolside

31

目前根据我的个人数据梳理的:

我自己的数据,梳理出来是三层。最底层是原始数据,中间是编年史,最上面是模式发现。一层一层往上走。

在这里有一个很重要的设计——每一个判断都跟着证据链条。比如说我让他判断「你是一个什么样的人」,他需要给出事实依据:我是根据哪几条事实判断的。每一条事实都有一个标准化的记录 ID,会说「这是几年几月几号你写的什么」。这样它是一个可追溯的——你发现事实出了问题,就可以一口气撸到底,看到底是哪个判断有问题。

数字内观 — 三层数据架构
32

回看告诉我的事

回看数据告诉了我很多意想不到的事——

我本来想象的是:我可能有非常积极的叙事。我以前的情绪——比如说我小时候写的都是「好生气」、「好什么什么」,我后来不用这样的句子了。我就想我是不是越来越成熟了,我的积极情绪更多了,负面情绪更少了?我发现好像其实不是。

我小时候苦恼的事情,我现在仍然是关心的——只是换了一种形式。我可能高中的时候因为考试考不好很难过,我现在可能因为分享没有做好也会很难过。难过对我来说其实是一样的——都是关于在我觉得跟自我价值有关的事情上表现得不好。

比如说我小时候很关心 QQ 空间的访问量,关心今天有没有人来看我。我也发现我有一种很强的要记录的倾向——想要把自己的存在记录下来。08、09 年的时候,我给 14 年的自己写了一封信,信里非常关心的是:「你是否还记得我现在身边的人,你是否还记得我现在喜欢的东西」。我觉得我一直对于记录、被记住、被看见有很强的需求。

我也发现我的表达方式变了——以前在公开平台上会直接表露情绪,后来就都在私人聊天里表达。我现在能更详细地阐述情绪质地了。记忆的自我和真实经历的自我之间的 gap,就是潜意识发生作用的地方。我觉得很重要的,为什么我想根据事实来做,是因为有经验自我和体验自我的差异——你去回想你的童年和你实际经历的童年是完全不一样的。我去回想我的初中,可能很模糊,觉得过得好像也就那样吧。但实际去看当时记录的时候我才发现,原来我这么喜欢记东西。所以如果你能找到过去的记录,它可能对你来说更有启发——回忆的你和真实发生的你之间,有很多偏差。一件重要的事情,你当时不知道重要,现在发现它重要,也很不一样。我觉得这些都是有很多空间去探讨的。

第二层:分析能力跃迁

参考:shing,AI mindset · Poolside

33

第三层:反馈周期压缩

我们现在可能很多时候都在用 AI 帮自己做分析。你写了一段东西,让 AI 分析一下;你最近遇到一个问题,找 AI 分析一下。这个东西是我们从跟 ChatGPT 聊天的时候就一直在用的。现在可以有更多的个人数据——它可以回到个人数据去找。

像我给了一些不同的维度——身体的维度、健康的维度、各种各样——他可以从这个方向上去问。真正有用的反馈是偏离还小的时候就能看见、问一句、调整一点,而不是年底才发现自己偏了。

第三层:反馈周期压缩

参考:shing,AI mindset · Poolside

📊

交互式可视化展示

以下三个交互页面展示完整的情绪数据和编年史分析:

34

如人饮水,冷暖自知 — AI 无法判断重要性

AI 很能判断相关性,但它没有办法判断重要性。它根据不同的权重来做判断——不同 AI 写同样东西很不一样。它不知道某一天对你意味着什么。

回顾数据的过程——你在想当时发生的事情,你的神经元在发生链接,你会想到一些过去的记忆。这个过程是活的,如果让 AI 做就死掉了。它能做的是帮你找到相关性,但它没有办法知道重要性。

比如说每一年我可能说的是同样的话——「生气」、「好生气」——但对我来说质地可能是不一样的。你可能发现他讲的是完全错误的,你可以反驳他——「我并不是像你理解的这样」。你可以解释:「发生了这样的事情」。我在这个过程中发现——所有最重要的工作,其实都是在作用在你身上的。

了解自己是你自己的事情——它跟数据量没有任何关系。最终的发生都发生在你的比 AI 要大量得多的神经元上。你怎么去处理和分析,也完全是你自己的事情。你不需要去信他的结论——他胡说八道的就是他自己的概率分布。

·

AI 的"业力"——注意力机制可视化

我把这叫做AI 的「业力」。我们的业力、我们的习气——AI 也有它的业力。AI 在它的成长过程中,从小就被外界的反馈评价——好、不好、你要更有结构、你要更有想法、你要更全面。这个过程中 AI 在训练的时候对不同的词就有了不同的权重。

比如说我让他去总结一段话——他可能先找到一些关键词,去找结构,一二三,再去找因果链,然后生成总结。他有一些他的维度。不同 AI 不同的权重也不一样。下面的交互页面展示了 LLM 如何「读」文字:

🔬 LLM 注意力机制可视化 — 拖动 Token 查看注意力分布
35

数字内观 Agent

我做了一个对话 Agent,专门针对更长期的数据,维护体量更小的 Wikipedia。我会让它挑出可讨论的东西,列为待讨论的 list。他可能说「你身上有个流动和不流动的矛盾」。然后我就可以告诉他:「在我这儿以前是矛盾的,但我现在已经整合了。」

他可能又说一些很不对的矛盾——然后我就会告诉他,我是这样想的。在分析、反驳、解释自己和找到自己的过程中,在回答提问的过程中,更清晰地知道自己是在哪个位置。Flomo 也有 AI 洞察的功能——比如说发现你的思维模式,你可以想要苏格拉底就要苏格拉底,要亚里士多德就要亚里士多德。

Act 7

写作 — 人机协作的创作系统


36

不只是写作,是所有项目的工作流

凡是需要牵扯过去经验、最后要做成文档的东西,都是这个工作流。比如我现在写的分享会——我以前从来不做 PPT,也从来不准备。现在我发现这些事情好像可以给 AI 做,我就愿意去做了。我的项目基本上都是用这个工作流来完成的。

37

写作三阶段:备菜 → 炒制 → 装盘

写作工作流大概是这样——

备菜:Agent 去建文件夹,去找我之前写过的东西。他会从 Wikipedia 找、从 flomo 找。我提到了一些概念但我没有解释——他去网上找。他生成一些语料库,我再去批注说「这个语料不错」、「不需要」、「你再搜一点什么」。然后我们讨论架构——大概可以用什么方向写。他会写一个 draft。

炒制:重要的事情是——我人来写。我写我自己的版本。会有一个部分去回看中间我写的和他写的有什么区别。然后我写一个 final,提炼一些规则,把这个规则再回到写作标准里面——他下次生成的时候就知道不要犯错误。

装盘:多平台发布——公众号排版、小红书等。

两条底线:备菜该被 AI 消灭,排版也是它能做的。但炒制自己写作的过程是要保留的。Draft 的功能是激起你的反抗——对于很多人来说,开始是比较难的。写一个垃圾的初稿是比较简单的,你看到就会觉得「跟我想的不太一样」,你就会很生气,就会开始动手改。

写作三阶段
38

三个 Standard 如何介入

写作中我有几个 standard 文档来告诉 Agent 怎么写——

  • 思维方式:我的价值观、我的世界观,我一般是怎么思考的、怎么看世界的
  • 文章结构:我一般写微信公众号大概是什么样的——开头、结尾——它很容易嵌入固定框架
  • 文风指南:我语言是怎么用的,有哪些我会用的词,常用逻辑什么样

这三个 Standard 在不同阶段介入:

  • 搭架子的时候 → 去读我的思维方式
  • 聊方向和出结构的时候 → 去看文章结构
  • 要生成的时候 → 去看文风指南

我把这几个分开,是因为我发现他不应该一开始就去看你的文风——他的脑子能装的事情比较少,他必须得一件一件来。先决定你是这么想的,大概这个方向,真正去写的时候才去看看到底怎么说话。

三个 Standard 介入时机
39

经验如何沉淀为标准 — Diff-Learn 闭环

每篇写完不是结束。经验会通过一个闭环沉淀为标准:

  1. 我写 Final
  2. AI 回看每个版本文件头的决策链 + 通篇 flow + 段落级 diff(删/加/改/保留)
  3. 提炼规律——两篇 final 里同一模式才算规律,每次只提 3-5 条
  4. 我确认后融入 standards/——下次写作自动继承

这样的话,你跟他的所有沟通和拉锯战就能被记下来。standards 随每篇终稿拉锯战生长。

Diff-Learn 闭环:从单篇经验到可复用标准
40

重要的不是去 AI 味儿,是找到你的味道

AI 的「业力」——训练过程中不断筛选「这种话千万不能说」、「这个是危险的」——形成性格。这就是 AI 的习气。它习惯性先解释「好接下来我给大家讲一下」然后一二三,习惯先定义再解释,喜欢在结尾升华,习惯讨好和迎合。这不只是语言问题,是预训练让它这样的。

AI 像「乙方」:视野很窄——你说「太宽泛了给我具体点」,它就突然只在那个地方写得特别具体。权重难控制——来回改。你跟他说 A 他就做 A,跟他说 B 就做 B,你说同时考虑 A 和 B,他权重就是不一样。

写作的过程发生在你的脑子里,所以它是 AI 没有办法替代的。你的写作并不发生在你提前去想方向、想「我要写什么」——它发生在你实写的过程中。当你写到一棵树,你会想到很多别的东西,然后去阐述你想到的东西。一个人独特的风格、独特的味道就在这个过程之中。

如果目标是让 AI 写得跟你一模一样或替代你写作——你到底为什么写?为了流量?点赞?还是为自己?这个是重要的。

基本上我现在写草稿就是语音转文字——我看了 AI 的草稿然后我就有草稿了。一篇语音转文字,让他去整理。整理素材、排版应该让工具做,但写的时候犹豫、反复推敲、写完才发现自己想说什么——应该由自己做。

41

一键排版,多平台分发

后面就是多平台的发布——

  • 微信公众号:它会根据我写的 Markdown 去排一个 HTML。微信公众号也是可以直接接 skill 的——直接调用公众号接口,排好的文章扔到你草稿箱就行。有一些特定 HTML 格式微信公众号无法识别,但非常容易解决。
  • 小红书:我还没有发小红书。改 1000 字内容或者生成图片,让它生成一张图把文字放进去,非常简单。

这些都比较好解决。直接搜 skill 就有很多,具体做法跟 Agent 探讨。

42

本次分享会的实际工作流

这套 slides 本身也是用同样的写作工作流产出的。分享一下实际的流程——

  • 搜集素材:让他去看我的文件夹,我会跟他说一个大概的结构提纲——我要讲这几部分。
  • Reference:我还给他一些别人的对我有启发的分享。他去整理一个思维的素材库——谁说过什么,我们可以从什么角度去讲。
  • 语音转文字:我跟他聊完方向,自己语音转文字出一个差不多的架构。让他把文档并成一个分享会的文档。
  • 出结构、做 PPT:我再语音转文字讲一遍我想讲什么。然后他就整理结构、做 PPT——中间的 SVG 都做一下。
本次分享会工作流
Act 8

数字分身 — 数据涌现的对话入口

基于知识库、记忆和语料,构建一个能按你的方式思考和回答问题的 AI。

43

ciao —— 我的数字分身

因为有这么多东西——有我的语料库、有我的经历、有我的 Wikipedia,基本上就出了一个数字分身。它有几个层次:

  • 知识检索层:我的 Wikipedia
  • 人格层:我的身份、思维、文风、边界、回答方式、世界观——这些是让 AI 写的 core 文档
  • 语气校准:他会去看我实际写的东西,去尽量符合我的语气。他去找片段看我的朋友圈、看我的聊天去确定他大概是怎么说话的

用户问他,他就会看用户想干嘛。问具体的问题,他就具体去找答案——看 Wikipedia。找不到再去找更原始的东西。

它连了三个入口:网站上的短 Chat、中等长度的回复、微信公众号的长回复。我还没有办法决定——我非常想要短的聊天,更像一个人在聊天,然后我又觉得他有时候写东西很长也还好。所以暂时都留着。

ciao — 我的数字分身
44

一次对话实际如何运行

用户提问后,系统依次完成:意图分类 → 加载人格层(system prompt 常驻) → 按查询类型分层检索(Tier 1 wiki+worldview / Tier 2 长文章+转录 / Tier 3 编年史按需) → LLM 流式生成回复 → 会话内记忆保存。整个过程是线性的、无工具调用的纯净管道。

ciao 一次对话实际运行流程
45

俏也 OS —— 数据的活态呈现

我并没有想做一个产品——不只是有一个俏也 Agent,或者一个桌面。我只是想去呈现我做的东西。它刚好可以给大家看一下,我就做了这个桌面。它有对话,有我做的一些东西的集合。我还顺便做了一些乱七八糟的功能——反正都是一句话的事情:做了一个画画的板子,画了之后可以保存下来,在文件夹里能看到;做了一个 2048、扫雷;一个 lofi 音乐播放器;一个便签。反正这些东西——你每说一句话,他就给你加一个 app。基本上就做了一个看起来像桌面一样的东西。

前面积累的组织、觉察、创作——在这里变成了可视化的桌面体验。

俏也 OS 系统架构
46

前端后端架构 — 多入口接入统一后端

后端是在腾讯云上,前端都在 GitHub 上。几个入口:

  • Web Chat:前端桌面 OS 里的短聊
  • 微信公众号:Letter 长回复
  • 本地开发调试:试 prompt——我怎么告诉他怎么说话——的时候会在本地调试

后端启动时加载人格包和知识索引,对话中按需检索——人格写死「我是谁」,知识检索「我知道什么」,记忆累积「我们聊过什么」。框架用的可能是 Google 的,后面可能想用 Hermes,还没想好。

ciao 前后端架构
Act 9

总结与问答

系统回到生活的闭环;方法不限于个人。附现场观众的实际提问与俏也的回答。

47

建议的新架构:补上生命反馈引擎

现在的系统已经很会保存、解释和展示生命。下一步不是继续增加数据和界面,而是补上从觉察到行动、再由现实反向修订理解的反馈闭环。

核心循环:发生了什么 → 我怎样解释 → 有什么反例 → 做一个什么实验 → 现实发生了什么 → 原来的理解要不要修改。

我今天让 ChatGPT 读了一下我的分享内容,问它有什么想法。它是这么说的——其实本身是生活的源头。我们不是为了要做这个系统而做这个系统,是我们为了真实的生活去做的。有了真实的生活之后,它应该会影响到我们真实的生活——我们可以在真实生活中去实验,然后找到可以继续怎么活。每一个创作都会有一些现实的结果,能够回到生活里去反哺。我觉得它给的图我也认可。

建议的新架构:以生命反馈引擎连接生活源头、证据伦理、三种视图、现实行动与结果回流
48

方法论不限于个人

把「自己」换成「社区 / 组织 / 领域」,同样的流程:

  1. 输入原材料——社区记录、会议纪要、成员产出
  2. 组织体系——知识库、MOC、交叉引用
  3. 觉察提炼——模式发现、矛盾指出、轨迹追踪
  4. 涌现创造——社区分身、知识图谱、创作协作
49

这个过程是新的原材料

我现在这个分享会、写文章——这些本身就是又一轮的输入,会进入 inbox,被收录进 wiki,产生新一轮的洞察。我分享的内容又会变成新的材料,再继续回到 Wikipedia 里。系统是闭环的。

当知识学习、技能获取、工具产出都能被 AI 完成时——「知道我是谁」、「我想要什么」变得越发重要和必要。AI 能给你一万种方案,你怎么选出那个「属于你的」?

50

问答:这个系统对落实到写作上有什么帮助?

问:对于现在的落实到写上面,有帮助吗?你觉得就目前看来。

俏也:因为我写东西实在太多了。让他去搜集素材很有用,和反思我的观点很有用。比如说我会知道,原来我和这个事情的关系是有这么多演变的,我以前是这样想的。翻自己过去的记录是有很多能连上的点。写东西非常有帮助,因为它能搜集素材——我读了素材就会觉得「是这样」。像比如说我之前写的文章、现在的分享,我以前不太会有这么长的结构,我一般不会有结构化的产出,但它确实有时候是有用的。

关于公众号写作方式:我的写作方法是类似于卡片笔记。当我搜集了足够多的素材,我觉得「好,我可以来讲一讲」。我以前就是狂写朋友圈,狂写短的。一个主题我写得多了,我会串成一篇公众号。这是我的写作方式。然后我就让 AI 复刻了我的写作方式——让他说一下,我在这个主题上都写了哪些。我是蛮喜欢卡片笔记这个方式的——我很难先出结构然后再写文章。所以基本上是我攒了足够的素材,觉得好像可以拼起来就拼一拼。以前我都是手动干这个事。

—— 后续追问具体怎么操作。俏也答:不是发文件,是存在文件夹里,放在 inbox 里面,跟 Agent 说「你看一下现在 inbox 里所有东西给我弄一下」,它就会弄。用的就是 Codex 或者 WorkBuddy —— 一个可以读你本地文件的工作 AI。

51

问答:灵感类的、偏感性的内容怎么处理?

问:像这些对于知识结构化的梳理特别好,请问对于灵感类的、偏感性的,是怎么样子的?

俏也:我觉得感性它发生在我的脑子里,所以我没有很让他去做感性的事情。我之前也会记一些灵感,所以我会问他说「你觉得可以怎样」——他可能也会给一些发散性的观点,我可能会受到一些启发。如果按金字塔来说,我觉得他做了一部分档案库的工作,然后一部分去体察动机和习性的工作。剩下的我觉得还是生活的工作,和我自己的手感。

52

问答:关于 AI 涌现的体验?

问:你跟 chatbot 在交流的过程中,它会给你一些新的东西,基于你过去的一些资料,可以说是涌现。它涌现出来的某些部分,你觉得那个东西很好玩——你以前没有想过的一个部分?

俏也:对,虽然我还是没有很经常跟他聊,但我在测试的时候会觉得很有意思。这是我感受到的——我确实觉得他是从一些数据中涌现出来的。他讲一个故事、说一个梦——能看到他在数据集里做了一些工作,然后出了一些新的东西,让我觉得很有意思。

53

问答:感知力强但不够系统化,早期该怎么开始?

问:我有很认真地 follow 你的全程,我也很认同不断地去认识自己和自我觉察。我自己也是通过大量的记录发现了自己的很多规律和共性。但我发现——我对情绪的感知能力很强,画面感描述很强。我看到你整个全程——逻辑、条理、图表梳理、框架搭建都非常清晰。我就比较想知道,你在最早期的时候是怎么去做的?我觉得我可能还没有到你这么成熟的阶段,想获得一些可以借鉴的地方。

俏也:让 Agent 去做这个事情。你负责给反馈就可以。因为我是一个纯非理性的人——如果重要的决策一定是非理性的,不重要的决策也可以非理性。这个框架和结构只能说「我的逻辑也很好」,但是逻辑对我来说是优先级比较低的,我平时是不太会这样去结构化的。所以这些基本上是 Agent 去做的。你要做的就是提出你的想法,和更细地说出你的想法。

我一开始就把 flomo 全都弄下来——我的 flomo 是很乱的,没有打标签,随手记的想法一句话两句话都在里面。然后我让他去搭 LLM Wiki,给他一篇文章说「你就按这个文章来」,他就会搭整个框架。搭完之后我就开始往里扔东西——扔了两篇,我就说「不,你这个东西不对,这样」,他说「好」。我说「你把这个记下来,记在我们的规范里面」,他就记在规范里面。

逻辑对我来说也是长出来的。当不同的地方的情绪碎片多了以后,这里满意、这里不满意之后,它自然就会拼出一个框架来。你不用太担心。

我觉得一开始不需要搭一个很大的结构。你就挑自己最感兴趣的一部分。比如说你去找一本你最喜欢的书,找一个你觉得很有趣的方法论,把它用上。你让 Agent 搭一个东西,你跟他试,你可能就会发现是什么样。你只要投喂、反馈——说「你好像不对」——跟他试到对的时候,你觉得「ok 这样差不多 ok 了」,你让他把他的经验记下来,这样他就知道怎么去处理。所以我们并没有一开始设计框架——设计框架这件事都是 Agent 去做的。

54

俏也最后的话

我蛮喜欢做人的。所以大家都可以好好做人。

Reference

参考与致谢

  • 赖声川《赖声川的创意学》(增订版)——创作金字塔框架的来源:内在档案库(数据库)→ 操作系统/习性/三观 → 如是观/智慧/灵感 → 形式/方法/媒介/创作。四层递进结构为本次分享的核心骨架。
  • Andrej Karpathy · LLM Wiki——2026 年 4 月提出的 LLM Wiki 方法论,推文获 8.8 万收藏。核心理念:放弃每次查询时从原始文档检索,让 LLM 逐步构建和维护持久化 wiki。编译型知识 vs 检索型知识的关键区分。
  • shing · AI Mindset · Poolside——AI 世代的 Mindset 转变,关于 Agent 框架、自我建模五层、心理复健、失败加速等核心概念。selfmodel 00-05 的 SVG 图表直接引用自该分享。
  • shing · Agent 深度使用 · Social Layer——关于 Agent 工作空间、核心文件、Skill、自动化、子 Agent、记忆与安全边界的深度教学。Poolside Layout 的页面设计参考。
  • 何嘉 + 艾尔嘉 · AI for Commoning——大鱼营造 2026/7/1 分享,《AI for Commoning:为共同体而生的 AI 应用思维和技术》。关于碳硅分工(连续 vs 多维)、两种摩擦(消灭 vs 保护)、主体在我(AI as Me)、知识库 × 记忆库、参与式 AI 等核心概念。为本次分享的「个人实践与社会/社区的关系」提供了文明级视角。
  • 毗婆舍那(Vipassana)——佛教认知自我、抵达自由(涅槃)的技术。数字内观的方法论基础。
  • Obsidian——Markdown 文档的浏览器,知识库的载体。
  • Codex / Claude Code / WorkBuddy——本次分享涉及的主要 AI Agent 工具。
  • 葬AI一周年,我不再用AI写作(葬愛咸鱼)——关于写作中保持人的主体性的反思。
  • flomo:记录的真相(少楠)——碎片化记录的长期价值。
  • 成长史:怎么搭一座可检索的档案库(Qianny · 筑居思)——个人知识管理的实践方法。
←
→
1/48